
OpenAI Decisions APIとJevを精度・コスト・処理速度で比較する
OpenAI Decisions APIとJevを精度・コスト・処理速度で比較する
前回の記事では、Jevを使ってナレッジグラフの関係を選択する処理を評価しました。今回は同じデータを使い、OpenAI Decisions APIと精度・コスト・処理速度を比較してみました。
対象は日本語1,418件、英語1,418件です。文章から36種類の関係候補を1つ選ぶ処理で、結果は以下のとおりでした。表の精度・処理速度は日本語 / 英語の順です。
| 比較項目 | Jev | Decisions API |
|---|---|---|
| 精度(Accuracy) | 92.95% / 93.51% | 86.04% / 86.32% |
| 精度(F1) | 0.748 / 0.730 | 0.683 / 0.655 |
| コスト | 日英2,836件: 約0.46米ドル(参考推計)、入力100万トークン: 0.042米ドル | 日英2,836件: 約1.13米ドル(API報告トークンから換算)、入力100万トークン: 0.10米ドル |
| 処理速度 | p50: 232ms / 247ms、p95: 311ms / 324ms(過去の参考値) | p50: 248ms / 233ms、p95: 349ms / 358ms |
今回のデータでは、精度はJevが上回りました。Jevの費用は現行単価と代替tokenizerによる推計、処理時間は前回の測定値なので、これらは参考値として比較します。
精度の比較
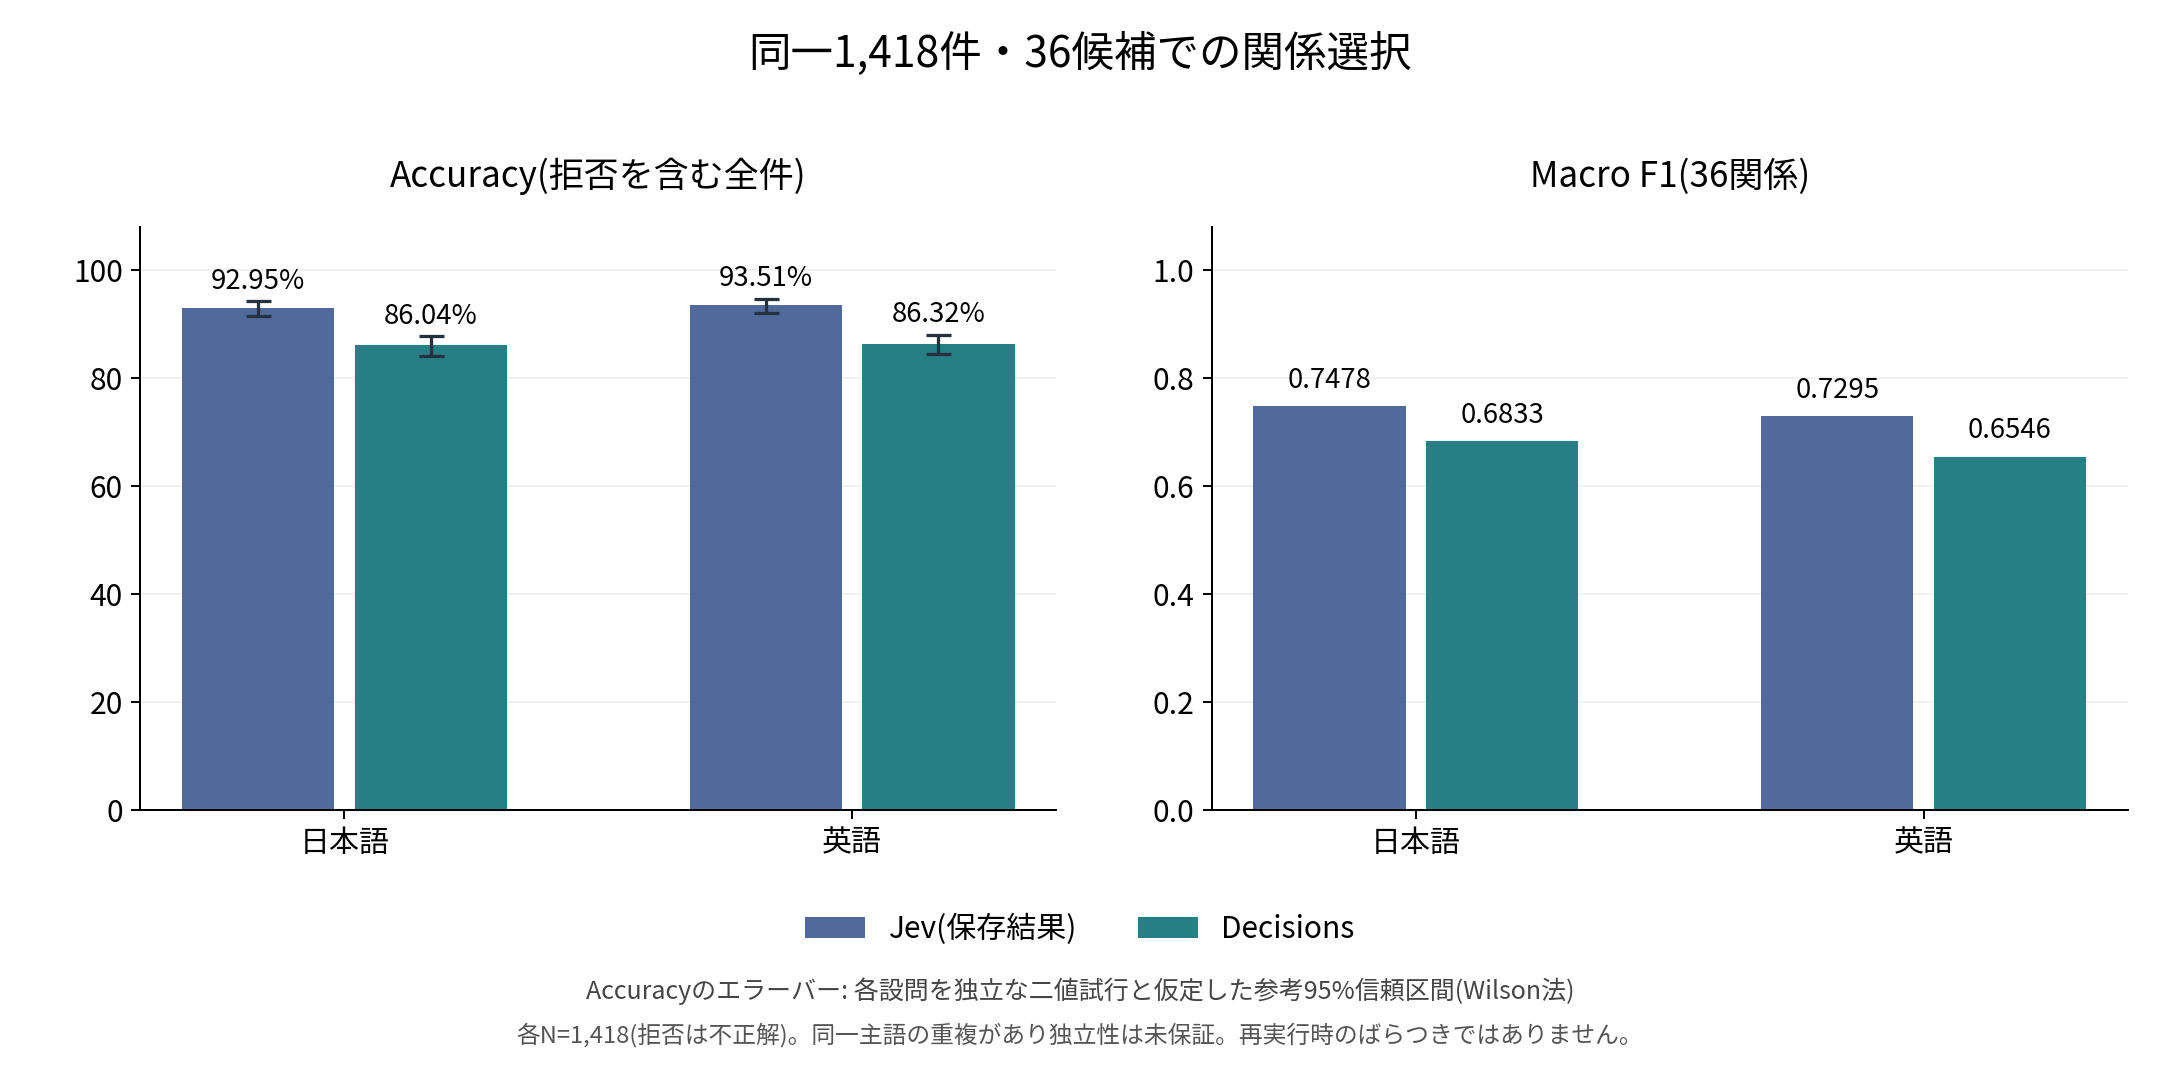
Accuracyは、Jevが日本語で6.91ポイント、英語で7.19ポイント高い結果となりました。関係ごとのF1を平均したMacro F1でもJevが上回っています。Decisionsの拒否回答は不正解として分母に含めました。
コストの比較
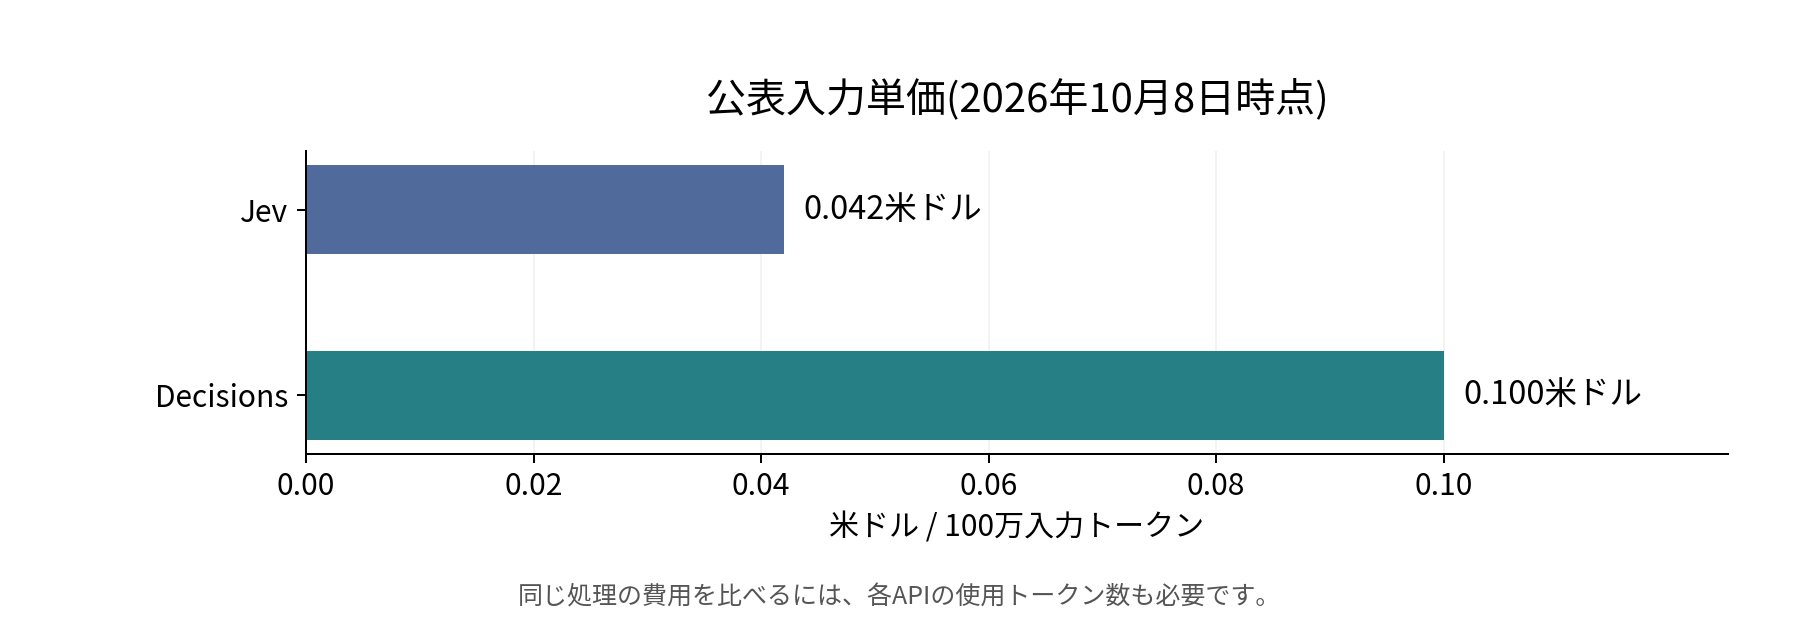
入力単価はJevが低く、どちらも出力トークンは無料です。今回の入力をo200k_baseで数えたJevの参考費用は約0.46米ドル、cl100k_baseでは約0.58米ドルでした。DecisionsはAPIが報告した使用トークン数から約1.13米ドルと換算できます。
この推計ではJevの方が低コストですが、Jevの実際の課金トークン数は未記録です。実費で何倍の差があるかまでは、この結果から判断できません。
処理速度の比較
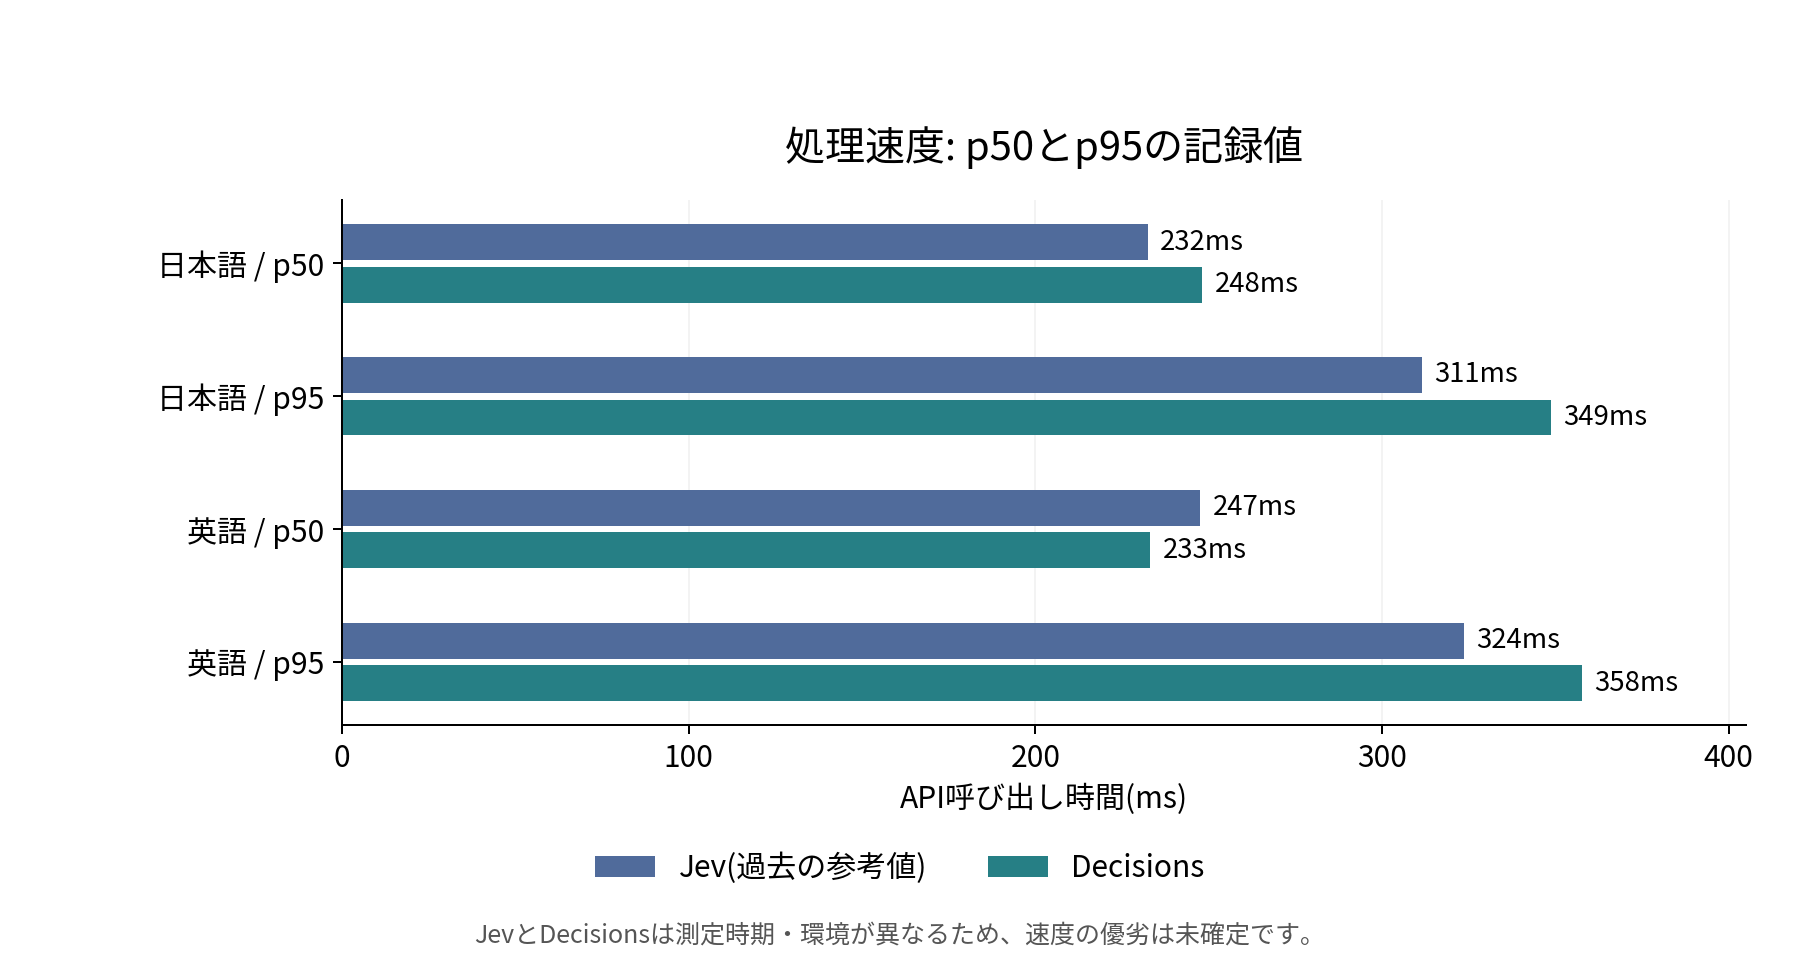
p50は中央値、p95は95%の呼び出しがその時間以内に終わる目安です。両APIともp50は約0.2秒台でした。記録上、p50は日本語でJev、英語でDecisionsが短く、p95は日英ともJevが短い結果となっています。
ただし、Jevは2026年9月の測定値で、実行環境も揃っていません。速度を理由に選ぶ場合は、同じ環境で測定する必要があります。
Decisions APIの拒否回答
Decisionsでは、日本語4件(0.28%)、英語27件(1.90%)がrefusalでした。候補を選ぶ回答の代わりに、質問への回答を断ったことを示す型が返ります。応答の形は以下のとおりです(説明用の例)。
{"type": "refusal", "name": "relation"}
拒否応答には選択結果・確率・信頼度・理由のフィールドがありません。このため、今回の拒否の原因は分かりません。
Jevの正常なChoice応答は、最高確率の候補と確率・信頼度を返す仕様で、公開された回答型に同等のrefusal型はありません。低い信頼度でも選択結果は返るため、APIによる拒否と、利用側で回答を保留する処理は分けて扱う必要があります。HTTP 429などのAPIエラーも拒否とは別です。
拒否を除いたDecisionsのAccuracyは、日本語86.28%、英語87.99%でした。拒否だけがJevとの精度差の原因ではありません。
評価条件
入力データとプロンプト
主語と目的語が分かっている状態で、(主語, ?, 目的語)の関係を選ぶ処理としました。
| 項目 | 条件 |
|---|---|
| データ | CoDEx-S test由来の日英共通1,418件 |
| 本文 | 前回保存した日本語記事抜粋・英語extract |
| 関係候補 | 対象データの正解関係から定義した36種類 |
| プロンプト | 本文、主語・目的語を含む指示文、候補名・説明・順序を共通化 |
| 各問題の正解 | 入力には含めず、評価に使用 |
| モデル | Decisionsはgpt-6-luna。Jevの当時のバージョンは未記録 |
日本語・英語の指示文は、両APIでそれぞれ以下の形式を使いました。
日本語Wikipedia本文に基づき、主語「{主語の名称}」と目的語「{目的語の名称}」の間に成立する関係を候補から選んでください。

Using the English Wikipedia extract, choose the relation that holds between the subject “{subject label}” and object “{object label}”.
全2,836件について元のJevコードから入力を再構成し、Decisionsに渡した本文・指示文・候補が一致することを確認しました。Decisionsは保存した送信ハッシュとも一致しています。Jevの過去のHTTP本文は未保存なので、元コードと固定データから確認できる範囲での照合です。
この評価は既定の36候補から選ぶ課題であり、未知の関係の発見や候補集合の作成は含みません。また、正解はグラフ上の事実なので、本文抜粋だけに根拠があるかは全件について確認できていません。日英の本文も翻訳対ではありません。
精度の集計方法
| 本文 | API | 正解 / 全件 | Accuracy | 参考95%Wilson区間 | Macro F1 |
|---|---|---|---|---|---|
| 日本語 | Jev | 1,318 / 1,418 | 92.95% | 91.50〜94.17% | 0.7478 |
| 日本語 | Decisions | 1,220 / 1,418 | 86.04% | 84.14〜87.74% | 0.6833 |
| 英語 | Jev | 1,326 / 1,418 | 93.51% | 92.11〜94.68% | 0.7295 |
| 英語 | Decisions | 1,224 / 1,418 | 86.32% | 84.43〜88.01% | 0.6546 |
Accuracyの分母は拒否を含む各1,418件、Macro F1は36関係の平均です。上位3関係が約62.3%を占める一方、10関係は各2件以下なので、少数関係のF1はわずかな正誤でも変動します。
エラーバーは、各設問を独立な二値試行と仮定した参考95%信頼区間(Wilson法、z = 1.95996398454)です。主語は810種類で記事に重複があるため、独立性は保証されません。再実行時のばらつきを示すものではなく、区間の重なりだけで両APIの差の有意性も判断できません。
コストの計算方法
Jevの使用トークン数が未記録のため、tiktoken 0.14.0の2種類のtokenizerで入力を数え、現行の入力単価0.042米ドル/100万トークンを掛けました。本文・指示文だけでなく、36候補の名前と説明を各リクエストに含めています。
| 算定方法 | 日本語のトークン数 | 英語のトークン数 | 日英合計の費用 |
|---|---|---|---|
| Jev: o200k_base・compact JSON(基準の推計) | 8,606,473 | 2,350,218 | 約0.46米ドル |
| Jev: o200k_base・各フィールドを個別に計数 | 8,473,378 | 2,220,863 | 約0.45米ドル |
| Jev: cl100k_base・compact JSON | 11,506,900 | 2,348,299 | 約0.58米ドル |
| Jev: cl100k_base・各フィールドを個別に計数 | 11,375,049 | 2,227,720 | 約0.57米ドル |
| Decisions: API報告値 | 8,833,591 | 2,470,749 | 約1.13米ドル |
JSON方式には、質問名relationなどの構造用キーや記号も含めています。個別計数は本文・指示文・候補名・説明だけを数えます。いずれもJevの内部形式や課金用tokenizerを再現したものではなく、4通りの値は実費の上下限や信頼区間ではありません。
Decisionsは合計11,304,340入力トークンに標準単価0.10米ドル/100万トークンを掛け、1.130434米ドルとしました。10%の地域追加料金を仮定すると約1.24米ドルですが、今回の適用と請求額は未確認です。Jevの内部の追加入力や当時の再試行も、この推計には含まれていません。
処理時間の計測方法
Decisionsは2026年10月8日にmacOS上のPythonから逐次実行しました。時間はHTTPSリクエスト開始から応答全体の読み取り・JSON解析までで、初回のTCP/TLS接続と拒否回答も含みます。p50/p95は前回と同じnearest-rank方式で求めました。
Jevの当時のSDK・実行地域・接続再利用の条件は未記録です。このため、API内部の処理速度だけを比較した値とはなっていません。
サンプルコード
同じ入力形式で評価するサンプルコードは以下から参照できます。2つのスクリプトは同じディレクトリに保存してください。引数は各スクリプトの--helpで確認できます。
- evaluate_relations.py: Decisionsによる関係選択と精度・処理時間の集計
- estimate_jev_cost.py: Jevの入力費用の参考推計
入力データの形式は前回の評価スクリプトと共通です。費用推計にはtiktoken==0.14.0と、公表されているencodingファイルを使用します。